
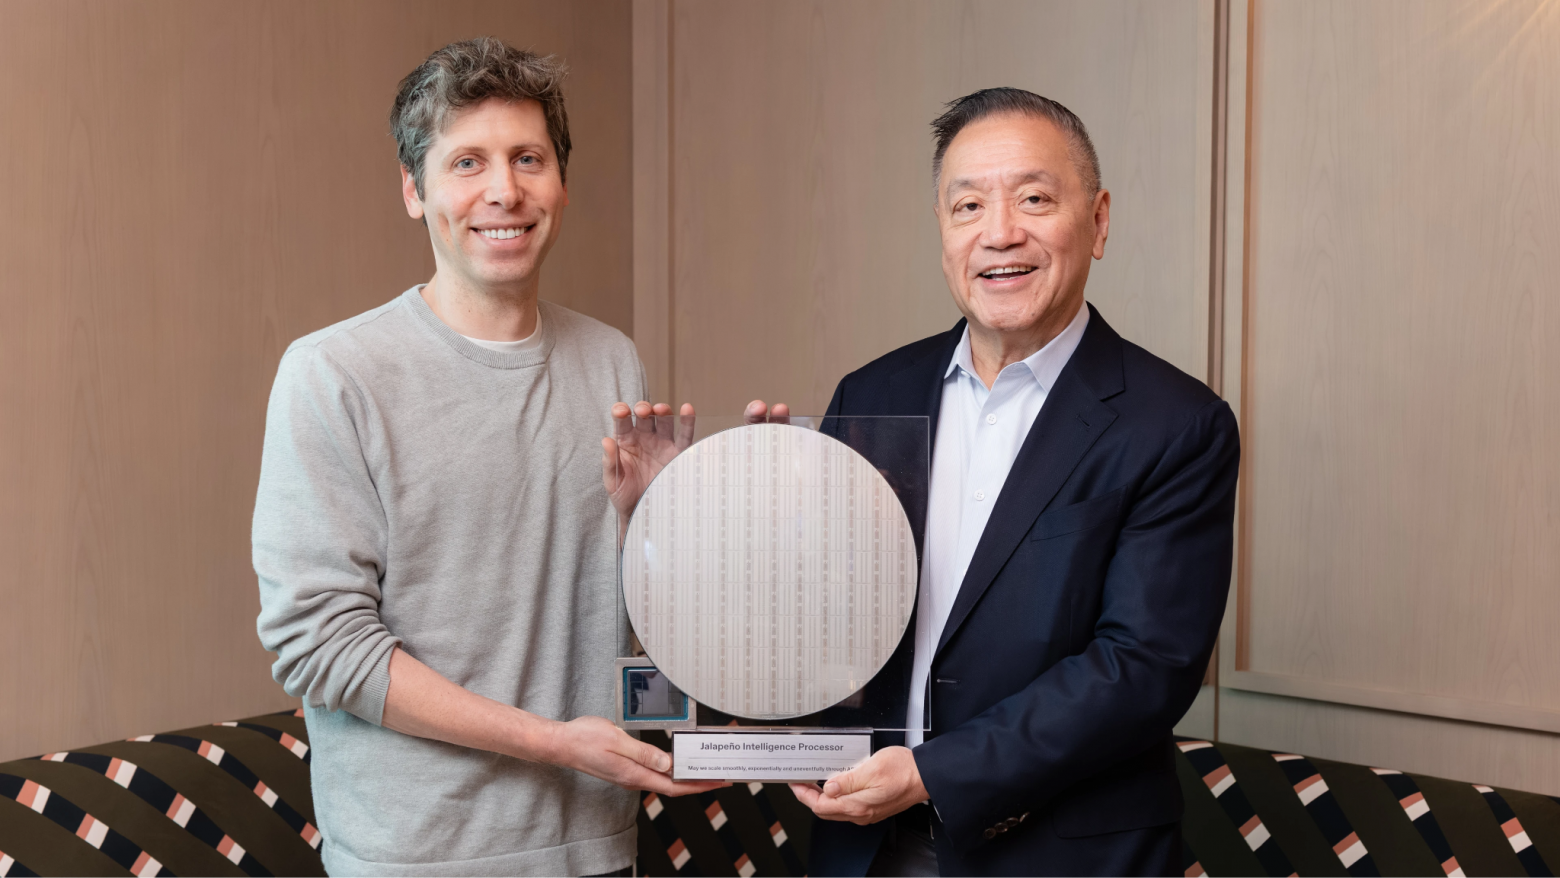
 естнадцать месяцев — ровно столько ушло у OpenAI от найма первых инженеров в середине 2024 года до готового процессора в кремнии. Компания решила соскочить с крючка сверхдорогих серверных ускорителей Nvidia и создала собственный чип Jalapeño в связке с Broadcom. Проект показали на конференции Hot Chips, а аналитики SemiAnalysis лично протестировали новинку в лаборатории разработчиков на наборе тестов InferenceX. И здесь кроется главный сюрприз: первое же поколение кремния от создателей ChatGPT умудрилось обойти не только решения AMD и Google, но и флагман Nvidia Blackwell по отдаче токенов на мегаватт потребляемой мощности.
Зачем делать свой процессор
Механика здесь предельно практичная. Привычные видеокарты Nvidia универсальны: они тянут всё подряд — от 3D-графики в играх до тяжелого обучения нейросетей с нуля. Процессор Jalapeño спроектирован как специализированный чип (ASIC) строго под инференс — то есть исключительно под выдачу готовых ответов пользователям. По данным SemiAnalysis, чип использует скоростную память HBM4 и не привязан к одной закрытой экосистеме: на нём без проблем запускали сторонние открытые модели вроде DeepSeek R1, Kimi-K2.5 и GPT-OSS, а ради демонстрации гибкости с помощью подсказок Codex даже запустили культовый Doom.
В реальных тестах разница видна невооружённым глазом. При работе с моделью DeepSeek R1 в режиме одиночного пользователя Jalapeño выдаёт свыше 700 токенов в секунду, а на Kimi-K2.5 и GPT-OSS скорость доходит примерно до 1400 токенов в секунду на человека. Причём такой темп держится на базовом алгоритме без программных ухищрений, спекулятивного декодирования и сложного разделения вычислительных фаз.
Jalapeño разносит все остальные чипы по показателю perf/W — пропускной способности токенов на мегаватт всей системы.
При этом тесты GSM8k evals подтвердили: точность вычислений и качество ответов у Jalapeño ничем не уступают флагманским решениям Nvidia.
Что изменится на экране вашего смартфона
Переводим с инженерного на человеческий: для обычного пользователя, который ежедневно обращается к нейросетям, эта кремниевая война приносит два понятных плюса. Первый — исчезновение раздражающих задержек. В часы пик, когда миллионы людей одновременно требуют сгенерировать текст или проверить код, серверы на специализированных чипах не захлёбываются от перегрузки. Тот самый эффект, когда ответ мучительно печатается по одной букве в секунду, упирается именно в потолок пропускной способности серверного железа.
Второй плюс — финансовый. Содержание гигантских дата-центров на чипах Nvidia влетает разработчикам в астрономические суммы, и эту наценку за монополию в итоге перекладывают на нас с вами через дорожающие тарифы. Энергоэффективный процессор, который тратит меньше электричества на генерацию каждого слова, напрямую снижает совокупную стоимость владения инфраструктурой. Правда, аналитики из SemiAnalysis делают важную оговорку: все замеры пока проводились на стендах самой OpenAI, а независимые тесты с длинным контекстом эксперты ещё ждут.
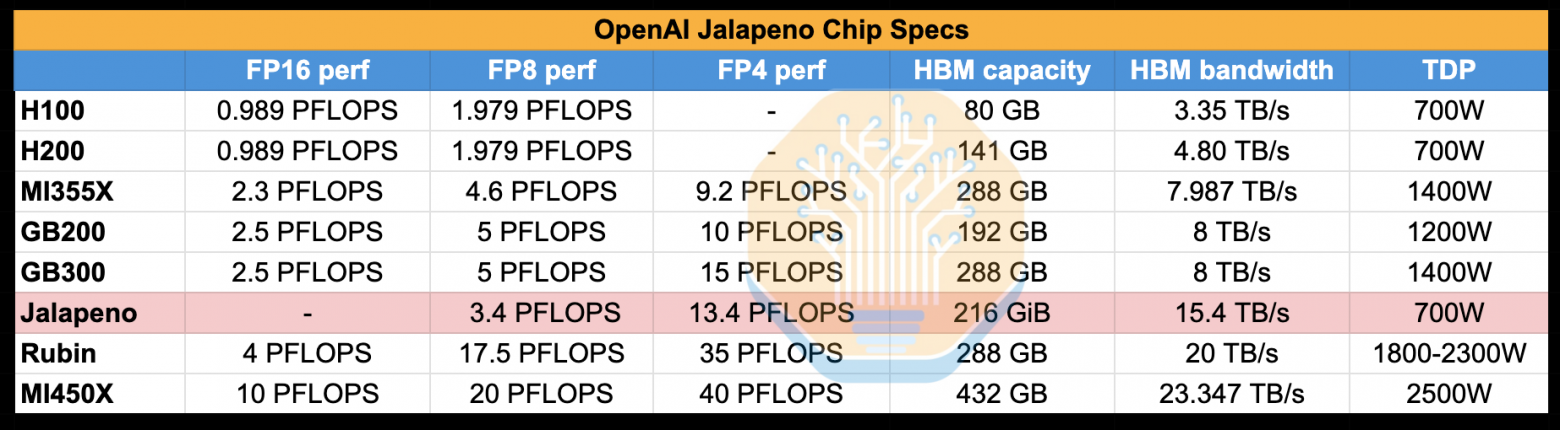
На наш взгляд, OpenAI наглядно доказала, что монополию Nvidia можно ощутимо потеснить. Если дорогое зелёное железо перестанет быть безальтернативным стандартом для серверных стоек, диалоги с ChatGPT станут заметно быстрее, а ценники на платную подписку перестанут расти с каждым новым обновлением.